TURF (Total Unduplicated Reach and Frequency) ist eine Analyse, kein Fragetyp. Sie läuft nach der Feldphase auf den Daten und findet die Kombination aus Produkten, Sorten oder Claims, die die meisten Befragten erreicht. Ihre Grundlage ist eine ganz normale Frage: ein Kaufbereitschafts-Gitter („Wie wahrscheinlich würden Sie ... kaufen?“ für jedes Item) oder eine Mehrfachauswahl („Welche davon würden Sie kaufen?“). Markieren Sie diese Frage in ihrem Erwartungen-Dialog als TURF, dann prüft SurveyTester über Ihre Testläufe, ob sie erhebt, was die Analyse braucht: jedes Item für jeden Befragten, eine rotierte Reihenfolge, eine Antwortskala, keine Begrenzung der Antworten, ein exklusives „Keine davon“ und dieselben Items in jeder Sprache. Reichweite und Frequenz berechnet SurveyTester nicht.
Was ein TURF-Design von der Programmierung braucht
Die Analyse ist nur belastbar, wenn die Frage von jedem Befragten ein vollständiges, unverzerrtes Bild erhebt:
- Jeder Befragte sieht jedes Item. TURF kombiniert Items je Befragtem. Ein Item, das jemand nie gesehen hat, zählt als „würde ich nicht kaufen“ und senkt unbemerkt seine Reichweite.
- Die Reihenfolge der Items rotiert. Items oben in einer langen Liste werden häufiger gewählt. Ohne Rotation gewinnen die ersten Items das TURF.
- Eine Antwortskala für alle Items (Gitter). Reichweite wird an einer Schwelle gezählt, etwa den beiden obersten Skalenpunkten. Das geht nur, wenn jede Zeile dieselbe Skala hat.
- Keine Begrenzung der Antworten (Mehrfachauswahl). „Wählen Sie bis zu 3“ kappt die Reichweite bei drei Items je Befragtem. Das Ergebnis beschreibt dann das Limit, nicht den Markt.
- Ein exklusives „Keine davon“ (Mehrfachauswahl). Wer nichts kaufen würde, braucht eine saubere Antwort statt eines zufälligen Kreuzes.
- Dieselbe Item-Liste in jeder Sprache und jeder Welle. Ein fehlendes oder zusammengelegtes Item in einem Land macht die Länder unvergleichbar.
Warum das ohne SurveyTester schwer zu testen ist
- Ein Interview zeigt eine Reihenfolge. Ob die Liste rotiert und ob „Keine davon“ unten bleibt, zeigt sich erst über viele Interviews.
- Fehlende Items fallen nicht auf. Ein Filter aus einer früheren Frage oder eine zufällige Teilmenge nimmt manchen Befragten Items weg. Die Seite sieht trotzdem vollständig aus, denn was fehlt, sieht der Tester nicht.
- Ein Limit wirkt harmlos. „Bitte wählen Sie bis zu 3“ liest sich wie eine Anweisung, nicht wie ein Designfehler.
- Übersetzungen weichen ab. Eine Sprache mit einer fehlenden Sorte geht unter Dutzenden Seiten leicht unter.
Wie SurveyTester eine TURF-Frage prüft
Kein Umfragesystem hat einen TURF-Fragetyp, daher kann SurveyTester eine TURF-Frage nicht selbst erkennen: Sie markieren sie. Öffnen Sie Fragen & Logik, klicken Sie in der Spalte Erwartungen der Frage auf das Bearbeiten-Symbol und setzen Sie Diese Frage speist eine TURF-Analyse. Der Dialog zeigt, welche Liste die Items enthält: die Zeilen eines Gitters oder die Antwortoptionen einer Mehrfachauswahl. Der Schalter steht für Gitter und Mehrfachauswahlen mit mindestens zwei Items zur Verfügung.
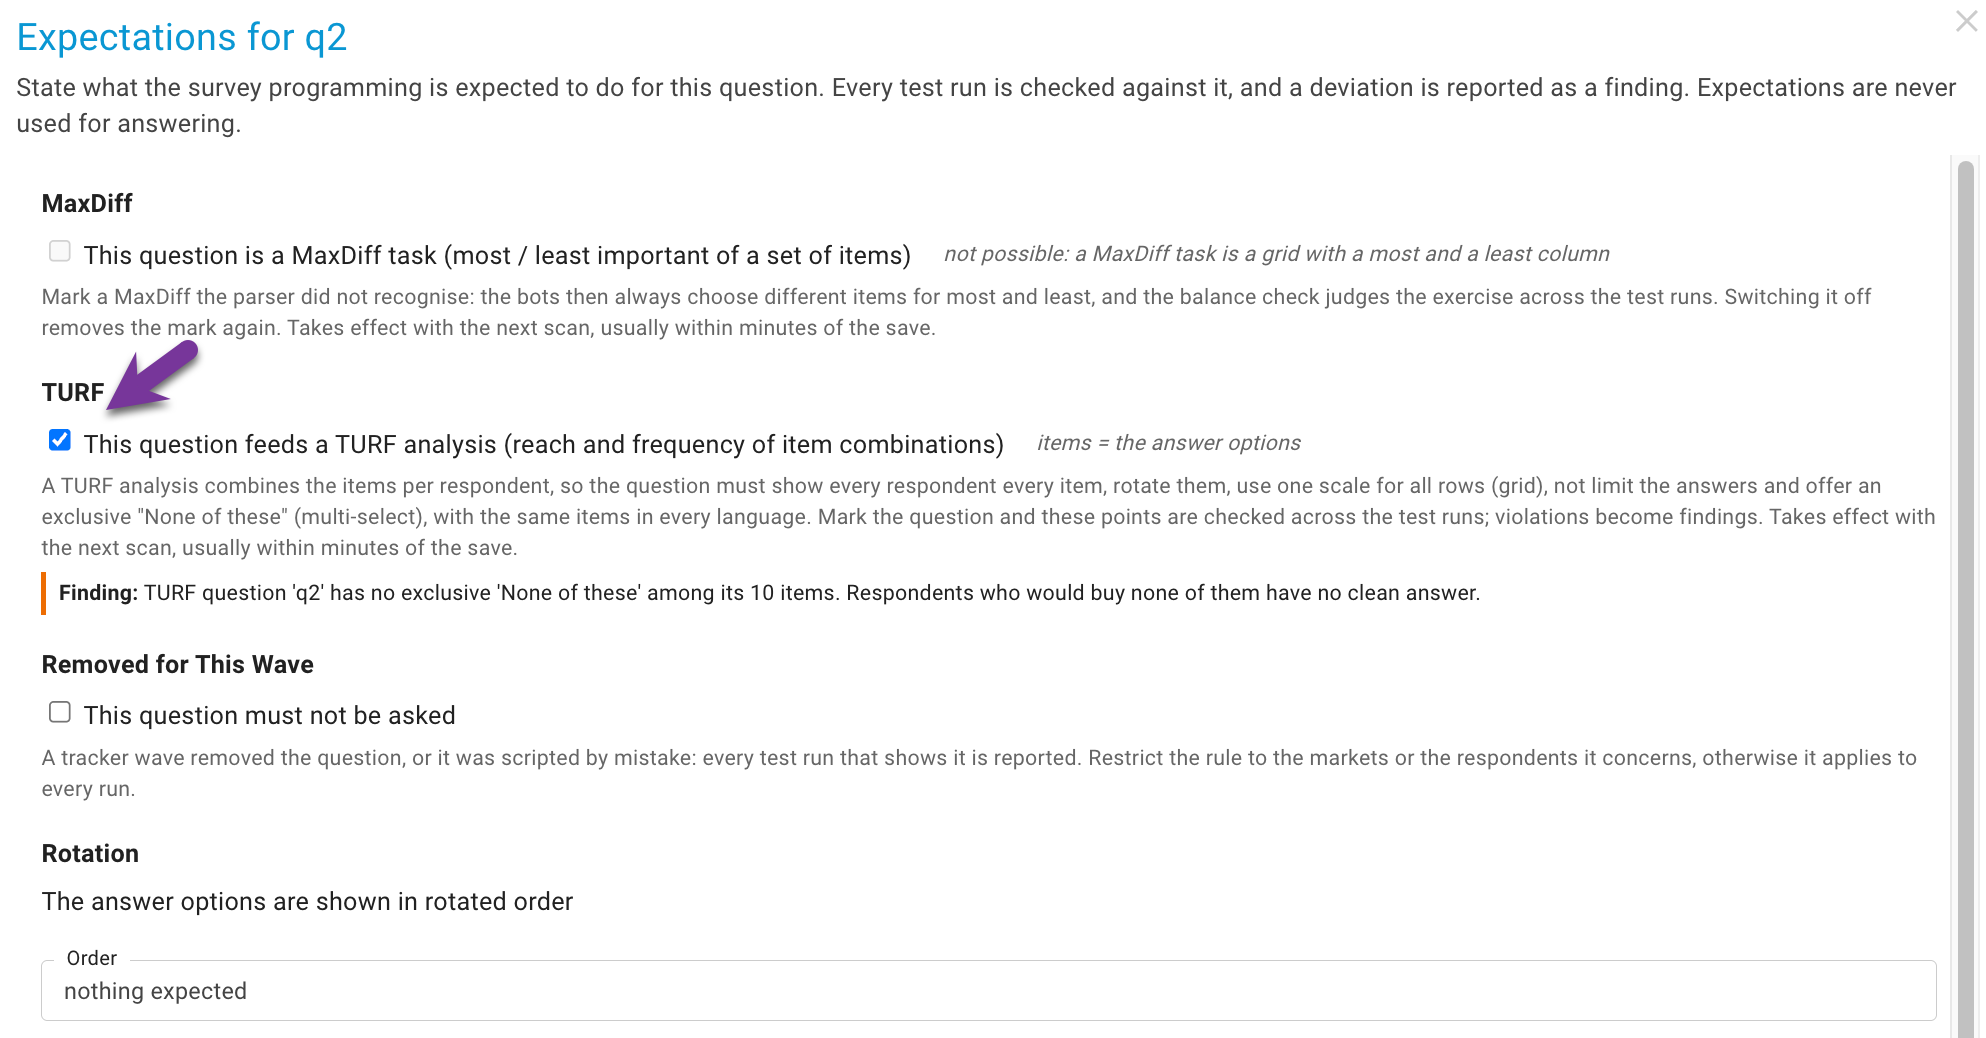
Von da an beurteilt jeder Scan der Testläufe die Frage:
| Prüfung | Was die Testläufe zeigen müssen | Beurteilt |
|---|---|---|
| Jeder Befragte sieht jedes Item | Jedes Mal, wenn die Frage gezeigt wurde, enthielt sie alle ihre Items. Items, die das Projekt kennt, die aber kein Lauf je gezeigt hat, zählen ebenfalls als fehlend. | sofort; nie gezeigte Items nach fünf Läufen |
| Die Reihenfolge rotiert | Zusammen gezeigte Items erscheinen über die Läufe in beiden Reihenfolgen. „Keine davon“ bleibt außen vor. | nach fünf Läufen |
| Eine Antwortskala für alle Zeilen | Alle Zeilen des Gitters tragen dieselben Antwortwerte. | sofort (nur Gitter) |
| Keine Begrenzung der Antworten | Die Umfrage akzeptiert so viele Antworten, wie es Items gibt. | sofort (nur Mehrfachauswahl) |
| Ein exklusives „Keine davon“ | Eine Antwortoption wählt alle anderen ab. Eine Überschreibung des Exklusiv-Kennzeichens durch einen Benutzer zählt. | sofort (nur Mehrfachauswahl) |
| Dieselben Items in jeder Sprache | Jede Sprache hat dieselben Items gezeigt. | sobald zwei Sprachen die Frage mindestens zweimal gezeigt haben |
In der Spalte Erwartungen erscheint eine TURF-Schaltfläche: grün, wenn jede Prüfung hält, rot bei einem Verstoß, gestrichelt, solange ein Urteil noch weitere Testläufe braucht. Sie öffnet eine Übersicht mit jeder Prüfung, dem, was die Läufe dazu gezeigt haben, und wie oft jedes Item gezeigt und zuerst gezeigt wurde.
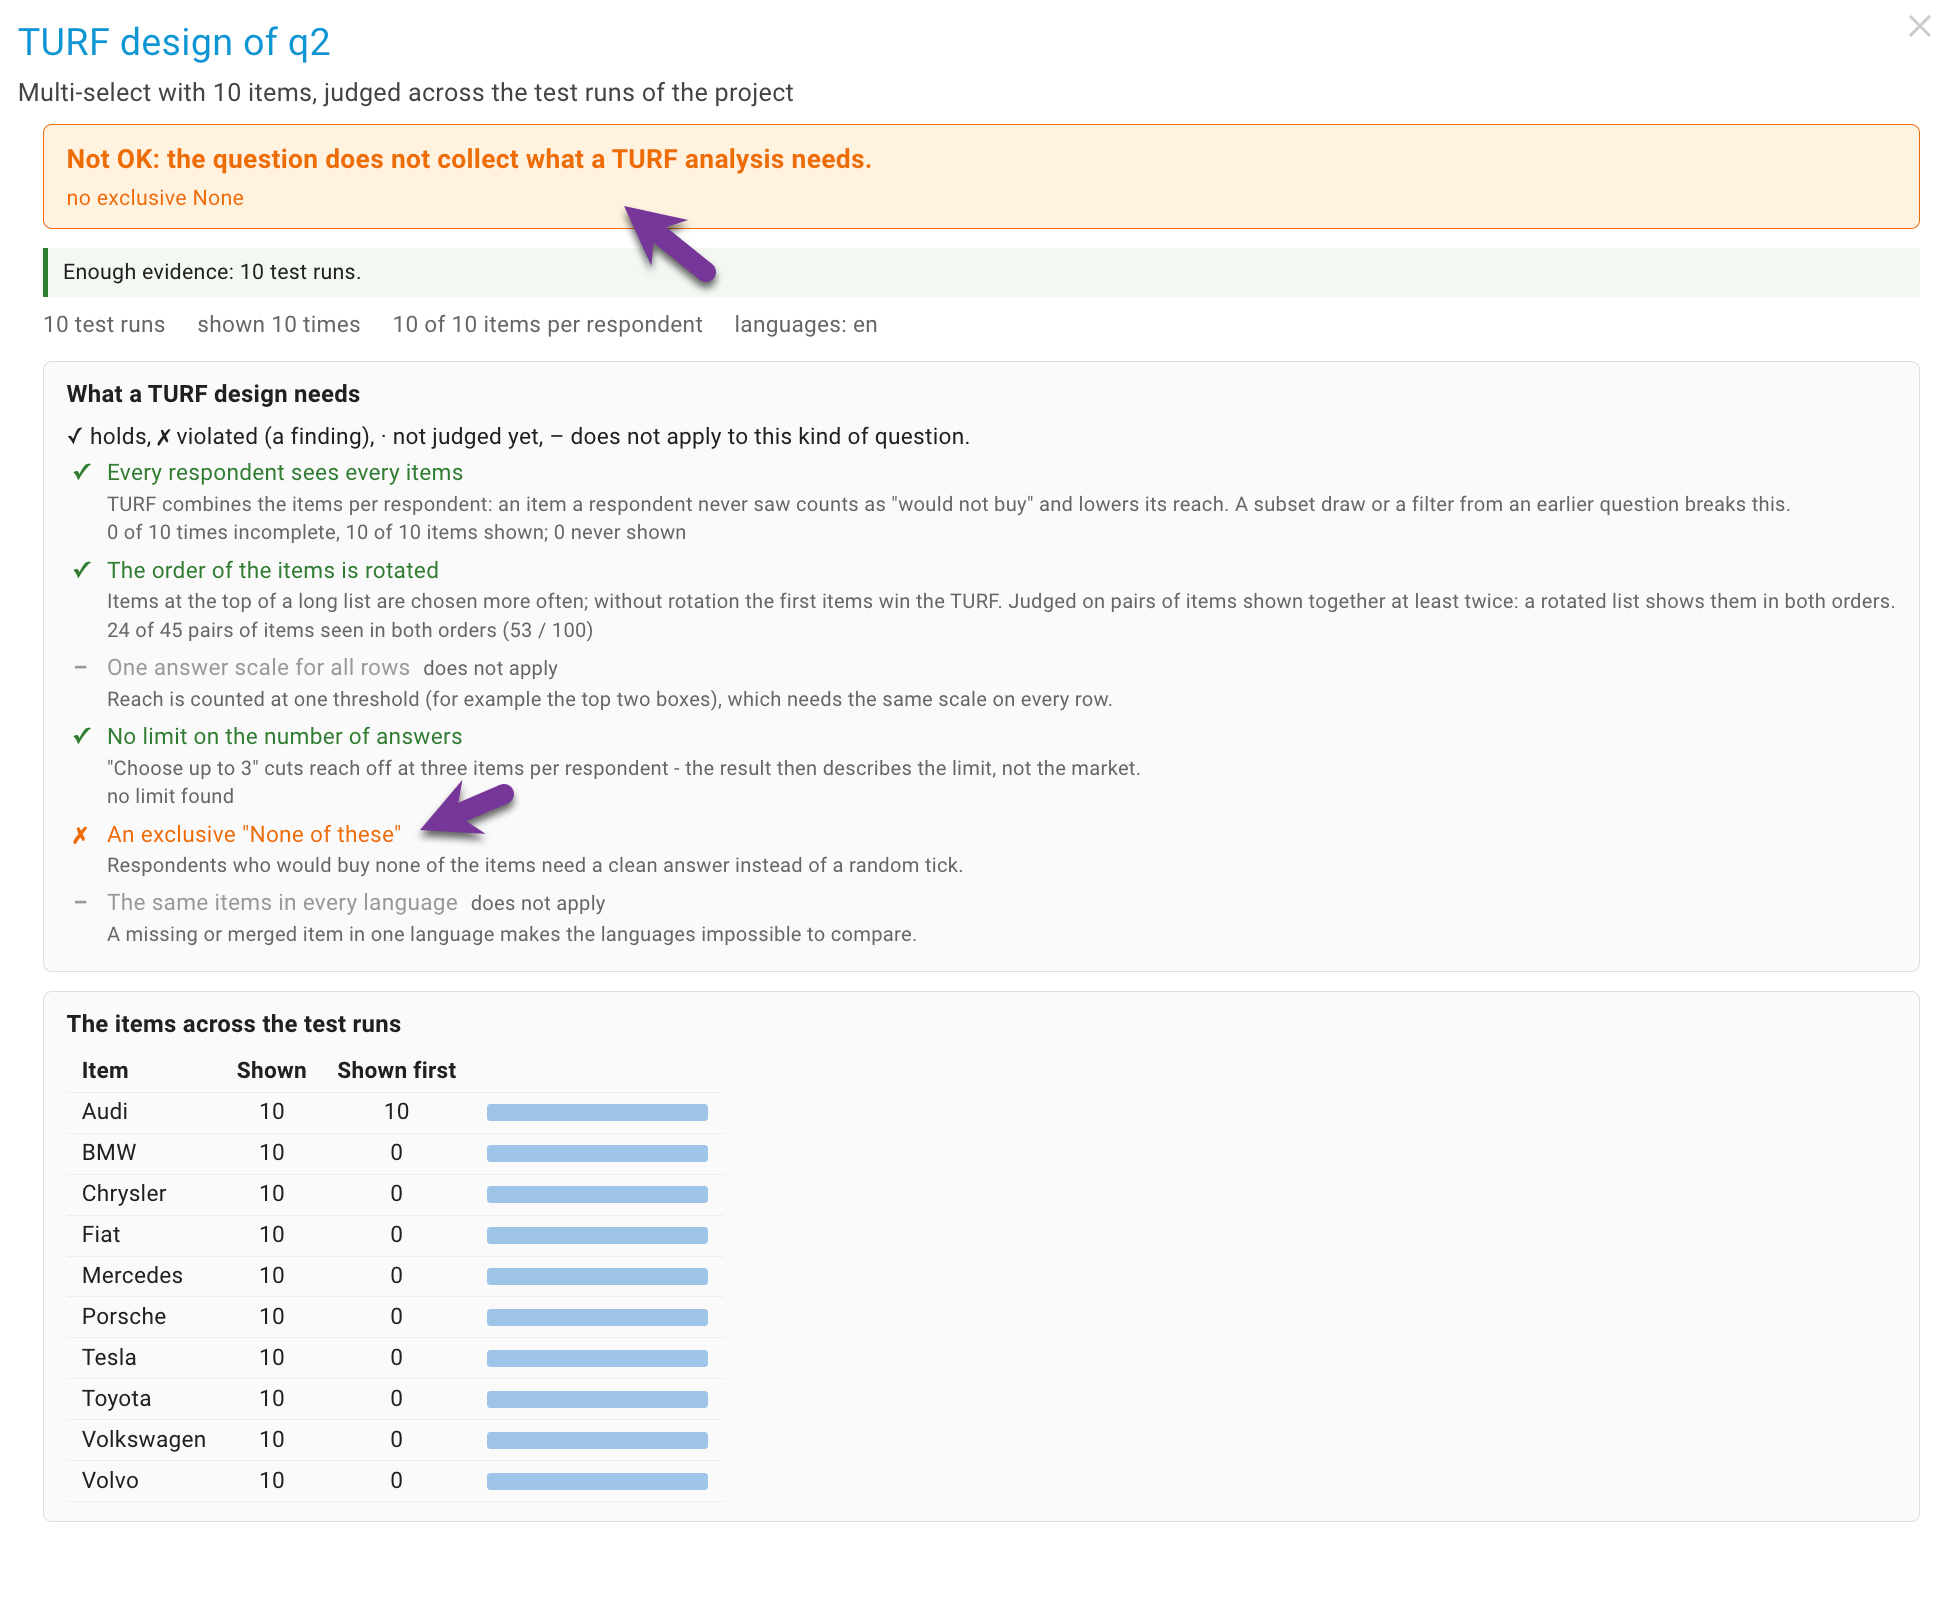
Jeder Verstoß ist ein Fund unter der Prüfung TURF-Design, geschrieben mit dem Testlauf, der ihn gezeigt hat. Wie jeder Fund kann er als Ticket übernommen oder abgelehnt werden. Er wird zurückgezogen, sobald die Prüfung wieder hält oder Sie die TURF-Markierung entfernen. Mit einem aktiven Ergebnisfilter (etwa einem Meilenstein nach einer Korrektur) wird die Übersicht nur für die gefilterten Läufe berechnet, so sehen Sie, ob die Korrektur gewirkt hat.
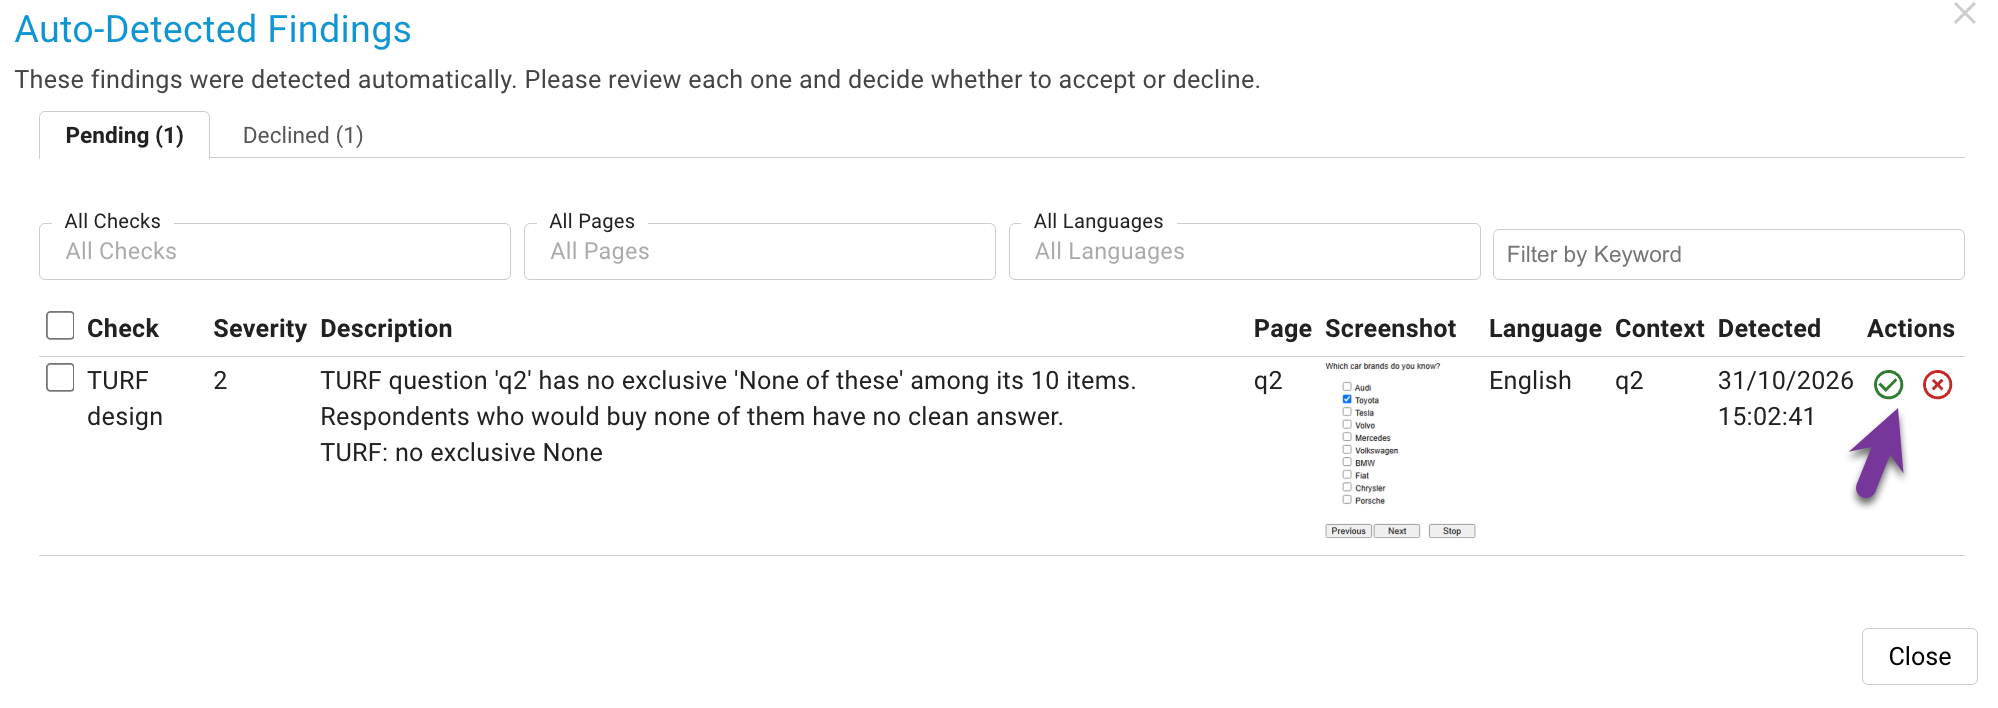
Schritt für Schritt
- Starten Sie eine erste Runde SurveyBots, damit die Seiten und die TURF-Frage erkannt werden.
- Markieren Sie die Frage. Öffnen Sie in Fragen & Logik den Erwartungen-Dialog der Frage, setzen Sie Diese Frage speist eine TURF-Analyse und speichern Sie.
- Starten Sie weitere SurveyBots, mindestens fünf Interviews, die die Frage erreichen, in jeder Sprache Ihres Feldes.
- Öffnen Sie die TURF-Schaltfläche in der Spalte Erwartungen und lesen Sie die Prüfungen. Geben Sie die Funde an die Programmierung.
- Starten Sie nach der Korrektur erneut. Setzen Sie einen Meilenstein und filtern Sie darauf, um den Stand seit der Korrektur zu sehen. Funde, die sich nicht mehr zeigen, werden zurückgezogen.
Gut zu wissen
- Wellen. Die Prüfungen vergleichen die Sprachen eines Projekts. Für den Vergleich der Item-Liste mit der vorherigen Welle nutzen Sie Ein Projekt mit der vorherigen Welle vergleichen.
- Das Antwortlimit wird von der Umfrageseite oder ihrer Fehlermeldung gelesen. Eine Umfrage, die zusätzliche Antworten stillschweigend ignoriert, zeigt kein Limit. Ein Testfall, der jedes Item wählt, gibt Gewissheit, siehe Bedingte Testfall-Antworten.
- Item-Texte prüft die Rechtschreibprüfung wie jede andere Beschriftung, siehe Rechtschreibprüfung.
- Prüfung abschalten. Die Prüfung heißt in den Auto-Detect-Einstellungen TURF-Design prüfen, siehe Auto Detect Issues.
Was SurveyTester nicht tut
- Keine TURF-Analyse. SurveyTester berechnet weder Reichweite noch Frequenz noch die beste Item-Kombination. SurveyBots antworten zufällig, ihre Reichweiten wären ohnehin bedeutungslos.
- Keine Prüfung der Schwelle. Welche Skalenpunkte als „würde kaufen“ zählen, wird in der Analyse entschieden, nicht in der Umfrage.
- Keine Prüfung des Datenexports. Wie die Items in der Datendatei codiert sind, liegt außerhalb der Umfrageseiten.
- Keine automatische Erkennung. Eine TURF-Frage sieht aus wie jedes andere Gitter oder jede Mehrfachauswahl; Sie markieren sie.
Das Wichtigste
Ein TURF-Ergebnis ist nur so gut wie die Frage dahinter. Markieren Sie die Frage als TURF, starten Sie Ihre SurveyBots, und die TURF-Schaltfläche sagt Ihnen, ob jeder Befragte jedes Item gesehen hat, rotiert, auf einer Skala, ohne Limit und mit einem sauberen „Keine davon“.