Ein MaxDiff gehört zu den Fragetypen, die sich von Hand am schwersten testen lassen: Jeder Teilnehmer sieht andere Item-Sets, und die Eigenschaften, auf die es ankommt - wird jedes Item gleich oft gezeigt, trifft jedes Item-Paar jemals aufeinander, werden die Zeilen rotiert - zeigen sich erst über viele Teilnehmer hinweg. SurveyTester beantwortet MaxDiff-Aufgaben wie ein Teilnehmer und beurteilt die Übung über alle ihre Testläufe. Das Urteil erscheint auf der Seite Seiten & Routing als Balance-Symbol mit einem Zusammenfassungsdialog, und jede Abweichung wird als Befund gemeldet.
Was ein MaxDiff ist
MaxDiff (Maximum Difference Scaling, auch Best-Worst-Scaling) misst die relative Wichtigkeit einer Liste von Items, zum Beispiel zwölf Merkmalen eines Produkts. Statt jedes Merkmal zu bewerten, sehen die Teilnehmer eine Folge von Aufgaben. Jede Aufgabe zeigt eine kleine Teilmenge der Items, meist vier oder fünf, und fragt nach dem wichtigsten und dem unwichtigsten.
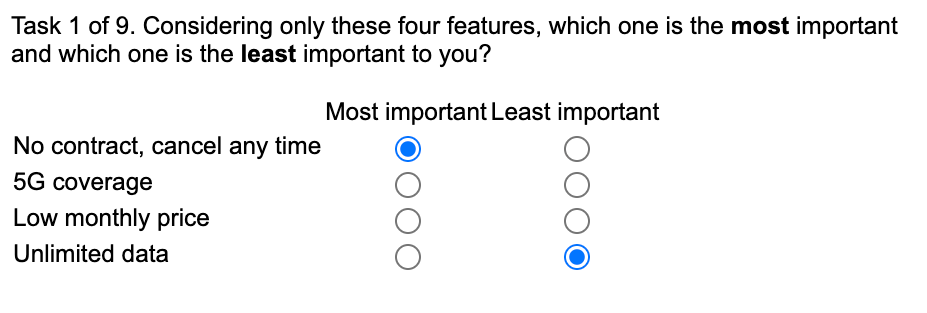
Hinter den Aufgaben steht ein Design: ein Plan, der festlegt, welche Items in welcher Aufgabe zusammen erscheinen. Ein gutes Design zeigt jedes Item gleich oft, lässt jedes Item-Paar etwa gleich oft aufeinandertreffen, verteilt die Items über die Zeilenpositionen und ist meist in mehrere Versionen aufgeteilt, denen die Teilnehmer zugeordnet werden. Die Umfrageplattform (Sawtooth, Decipher, Qualtrics, Alchemer, Dimensions und andere) erzeugt die Aufgaben zur Laufzeit aus diesem Design.
Warum das ohne SurveyTester schwer zu testen ist
- Ein Teilnehmer beweist nichts. Wer sich durch die Umfrage klickt, sieht eine Version mit neun oder fünfzehn Aufgaben. Ob Item 7 jemals auf Item 11 trifft oder ob Item 1 immer in der ersten Zeile steht, ist in einem einzelnen Durchlauf unsichtbar.
- Die Fehler sind statistisch, nicht sichtbar. Eine Aufgabenseite sieht auch dann in Ordnung aus, wenn das Design dahinter kaputt ist: ein Filter, der immer dasselbe Item weglässt, eine Versionszuteilung, die Version 4 nie erreicht, oder eine Zeilenreihenfolge, die der Item-Liste folgt statt zufällig zu sein.
- Die Validierungsregel ist leicht zu brechen. Die Umfrage muss eine Aufgabe zurückweisen, bei der wichtigstes und unwichtigstes dasselbe Item nennen. Eine fehlende oder falsche Regel fällt erst auf, wenn jemand genau das versucht.
- Zählen von Hand skaliert nicht. Item-Häufigkeit und Paarabdeckung zu prüfen heißt, Hunderte Aufgaben über Dutzende Teilnehmer zu tabellieren - Arbeit, die vor dem Start niemand macht.
SurveyTester übernimmt dieses Zählen, bei jedem Testlauf, und sagt in einer Zeile, ob die Übung sehr wahrscheinlich in Ordnung ist, nicht in Ordnung ist oder noch nicht beurteilt werden kann.
Wie SurveyTester ein MaxDiff testet
Erkennung und Beantwortung
SurveyTester erkennt MaxDiff-Aufgaben auf den unterstützten Umfrageplattformen an ihrer Struktur: ein Grid mit einer Spalte für wichtigstes und einer für unwichtigstes, jeweils eine Einfachauswahl über dieselben Items. Die SurveyBots wählen dann immer zwei verschiedene Items, bestehen die Validierung der Umfrage und der Testlauf läuft weiter wie ein echtes Interview. Wird eine Plattform oder Vorlage nicht erkannt, kannst du die Frage selbst als MaxDiff markieren (siehe unten).
Die Balance-Prüfung
Alle Aufgabenseiten einer Übung zählen als ein MaxDiff, auch wenn die Umfrage sie über neun oder fünfzehn Seiten verteilt. Über alle Testläufe des Projekts zählt SurveyTester, welche Items jede Aufgabe gezeigt hat, in welcher Zeile, zusammen mit welchen anderen Items, und was geantwortet wurde. Daraus beurteilt es vier Dinge:
| Prüfung | Was gezählt wird | Wann gemeldet wird |
|---|---|---|
| Wichtigstes nie gleich unwichtigstes | Jede abgeschickte Aufgabe: Hat die Umfrage dasselbe Item als wichtigstes und unwichtigstes akzeptiert? | Sofort, bei der ersten akzeptierten Aufgabe |
| Items gleich oft gezeigt | Wie oft jedes Item über alle Aufgaben aller Läufe erschien | Wenn das häufigste Item mehr als 1,5-mal so oft erscheint wie das seltenste |
| Zeilen rotiert | Ob Item-Paare jemals in beiden Reihenfolgen zu sehen waren (A über B und B über A) | Bei fester Zeilenreihenfolge - eine feste Reihenfolge liegt bei 0, auch wenn Items in der Mitte zu wandern scheinen |
| Paare teilen eine Aufgabe | Wie oft je zwei Items in derselben Aufgabe erschienen | Erst wenn genug Aufgaben gesehen wurden, damit jedes Paar etwa dreimal hätte zusammentreffen können; ein Paar, das dann immer noch nie zusammen war, deutet auf eine Lücke im Design hin |
Die Prüfungen vergleichen die Items miteinander, nicht mit einem Sollwert, daher braucht SurveyTester keine Kenntnis des Designs. Die Balance-Prüfungen warten eine Mindestzahl von Testläufen ab (standardmäßig fünf), bevor sie urteilen; die Validierungsprüfung meldet sofort.
Wo du das Ergebnis siehst
Öffne Seiten & Routing. Jede Aufgabenseite eines MaxDiff zeigt in der Spalte Erwartungen ein Balance-Symbol: grün, wenn die Prüfungen bestehen, orange, wenn eine Abweichung gefunden wurde, gestrichelt grau, solange noch nicht genug Läufe vorliegen.
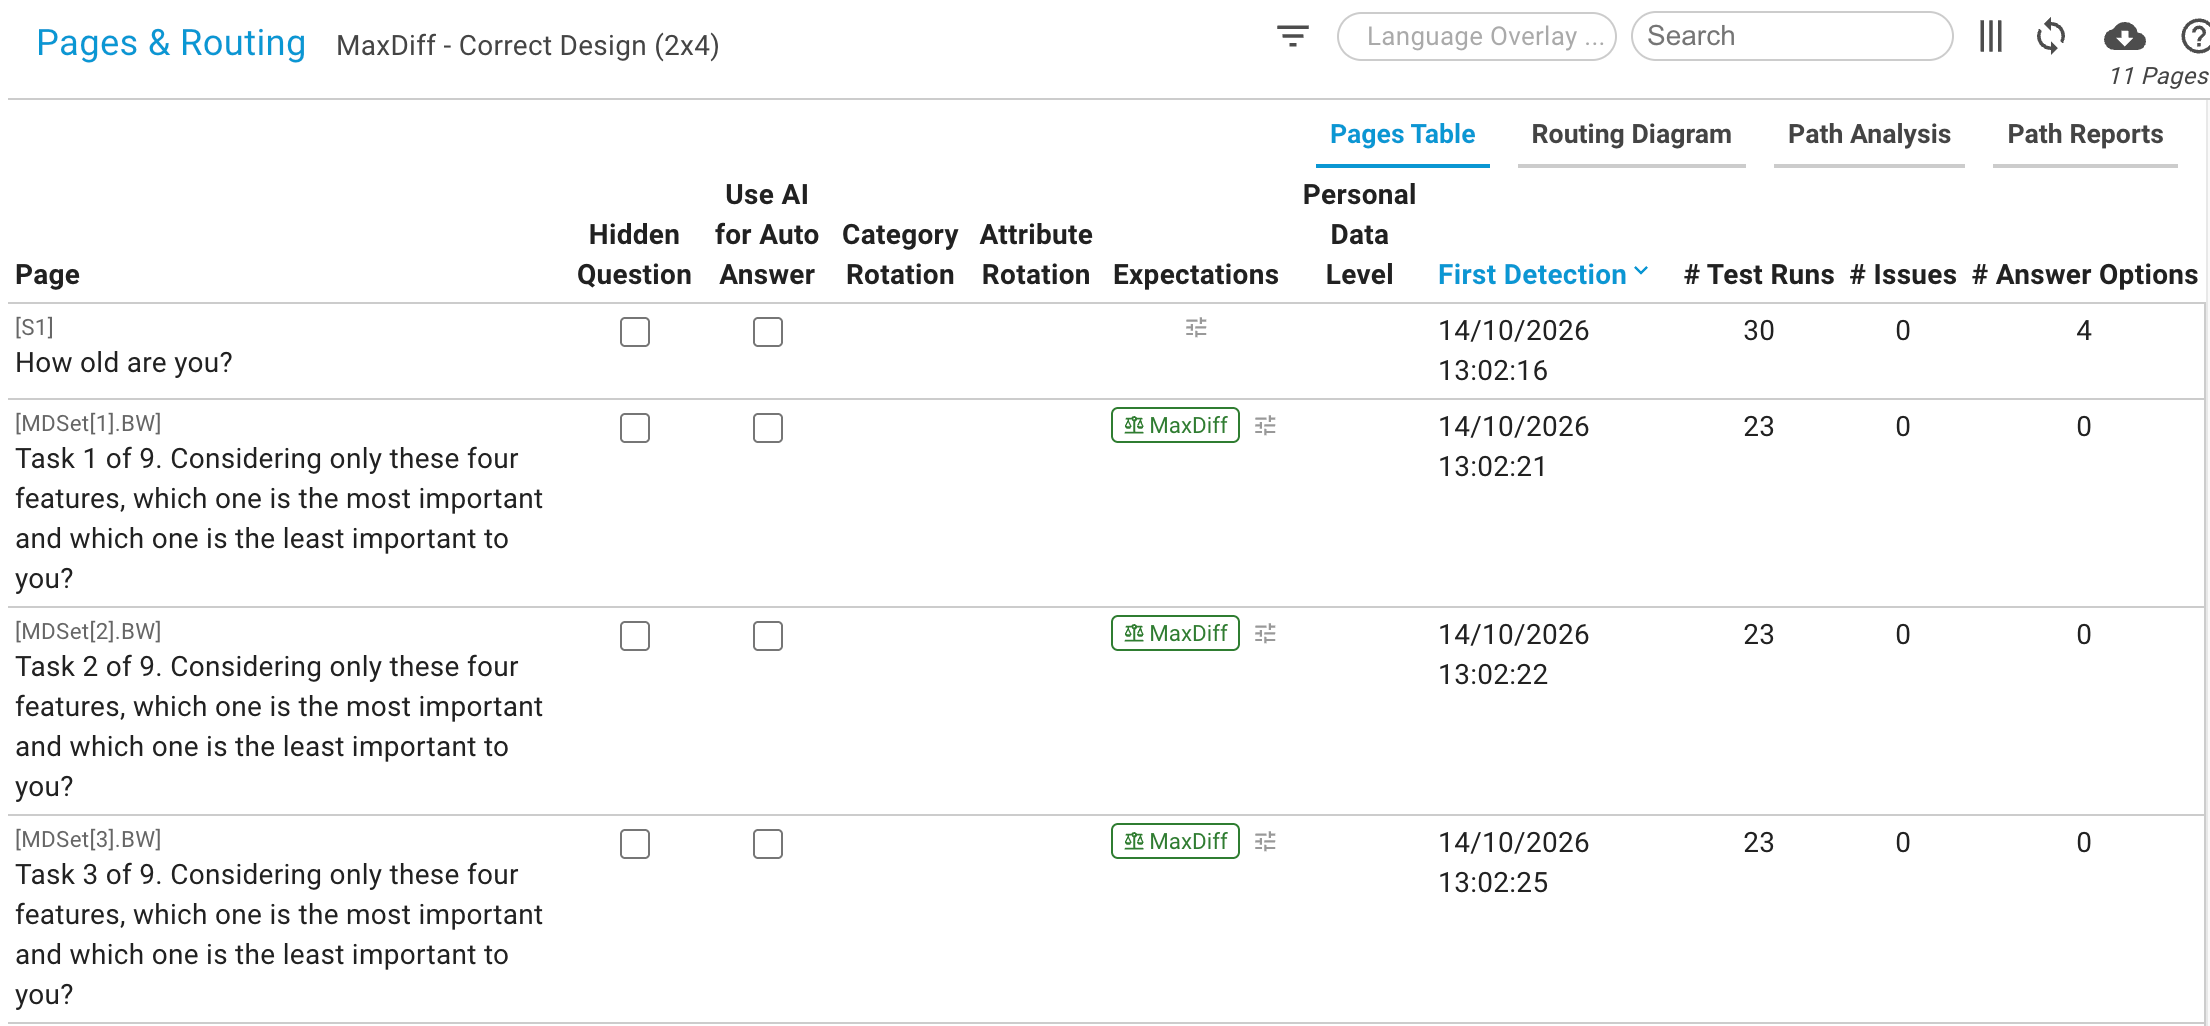
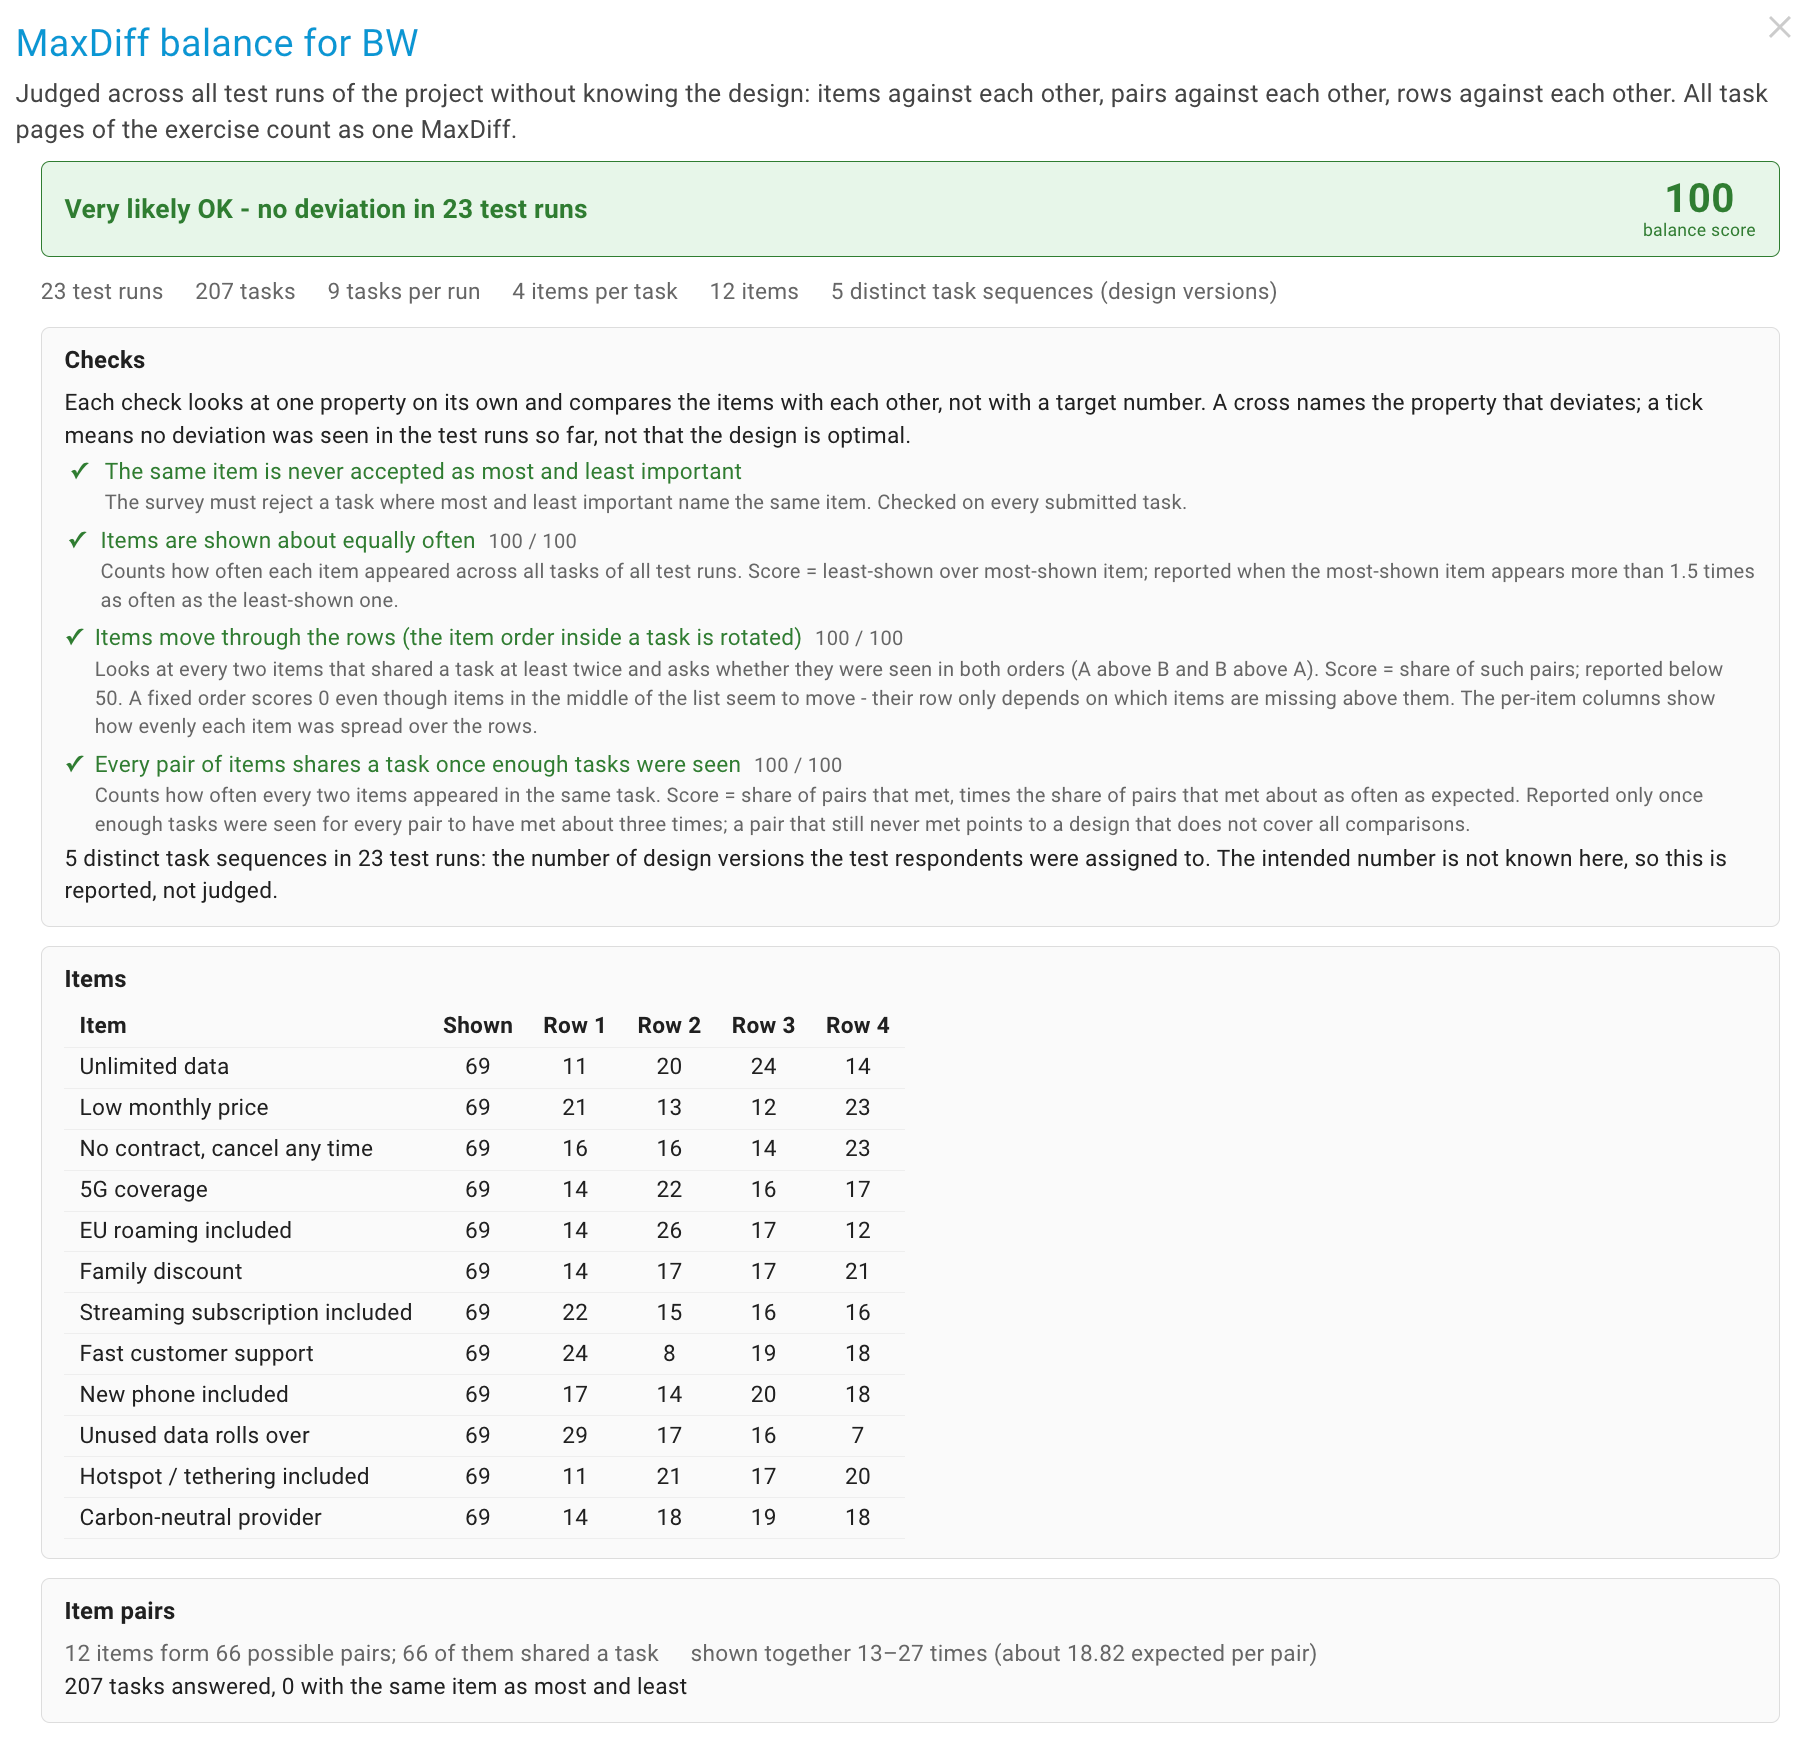
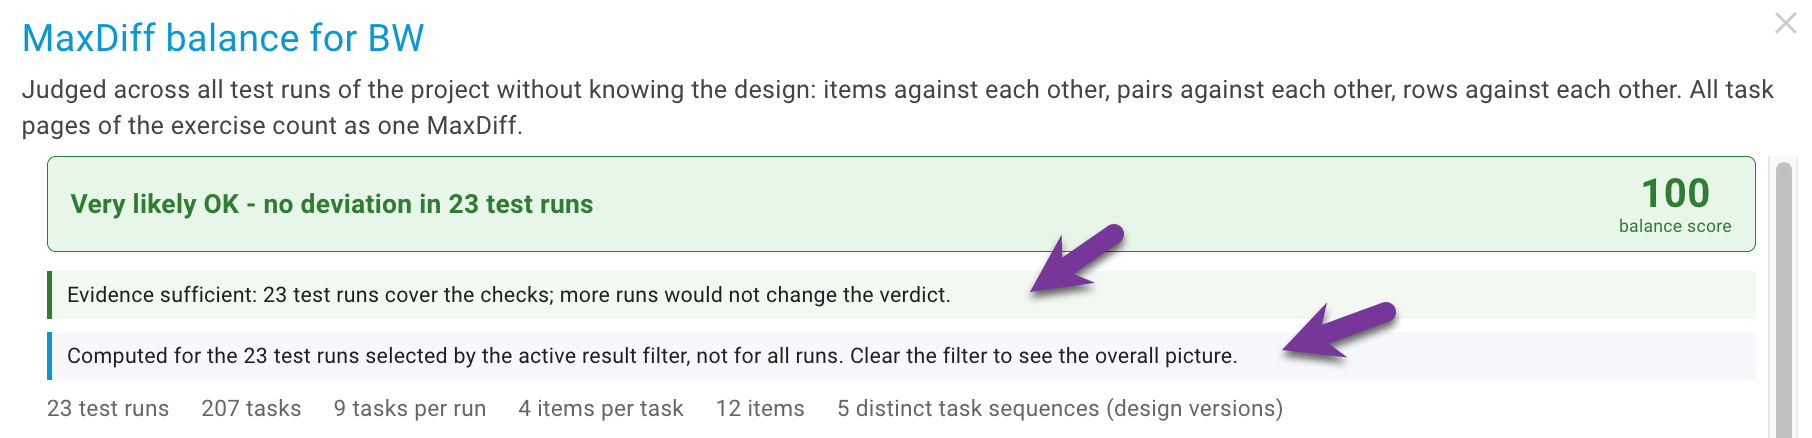
Ein Klick auf das Symbol öffnet den Dialog MaxDiff-Balance:
- Urteil - Sehr wahrscheinlich in Ordnung, Nicht in Ordnung mit den fehlgeschlagenen Prüfungen und ihren Zahlen, oder Noch kein Urteil mit der Zahl der noch nötigen Läufe - dazu ein Balance-Score von 0 bis 100.
- Beweislage - ob die Beweise ausreichen oder warum weitere Testläufe empfohlen werden: weniger Läufe als das Minimum, zu wenige Aufgaben für die Paar-Prüfung oder eine neue Aufgabenfolge, die in den letzten Läufen noch hinzukam (die Versionszuteilung ist noch nicht abgedeckt).
- Prüfungen - die vier Prüfungen mit Haken oder Kreuz, ihren Scores und einer kurzen Erklärung, was jede zählt.
- Items - jedes Item mit der Zahl seiner Anzeigen und deren Verteilung über die Zeilen.
- Item-Paare - wie viele der möglichen Paare eine Aufgabe geteilt haben, wie oft, und eine Liste aller Paare, die das nie getan haben.
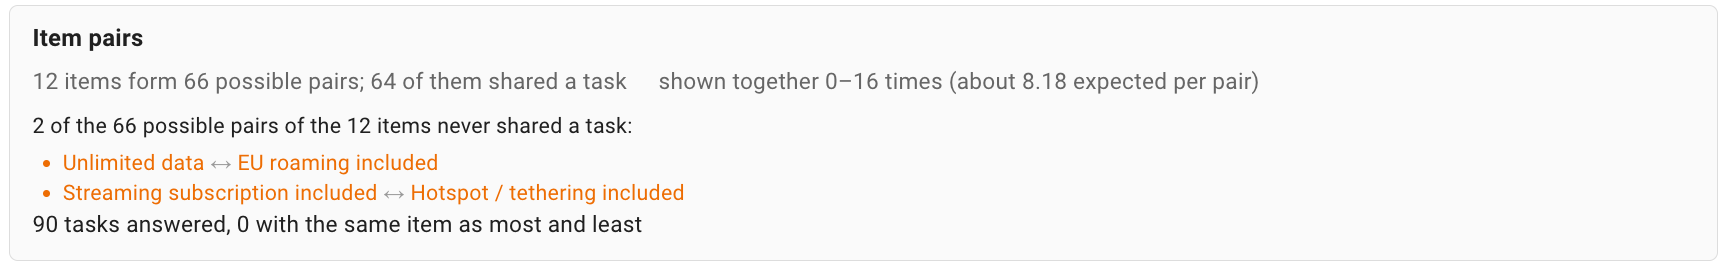
Die Zahlen werden vom Projekt-Scan aktualisiert, der nach abgeschlossenen Testläufen läuft. Lade die Seite nach einem Schwung Läufe neu, um den aktuellen Stand zu sehen.
Befunde
Jede Abweichung ist zugleich ein AutoDetect-Befund unter der Prüfung MaxDiff-Balance. Sie erscheint in der Befundliste, kann in ein Issue übernommen oder abgelehnt werden und wird automatisch zurückgezogen, sobald sie nicht mehr auftritt - zum Beispiel nachdem der Fragebogen-Autor die Zeilenrotation korrigiert hat und neue Testläufe das zeigen.
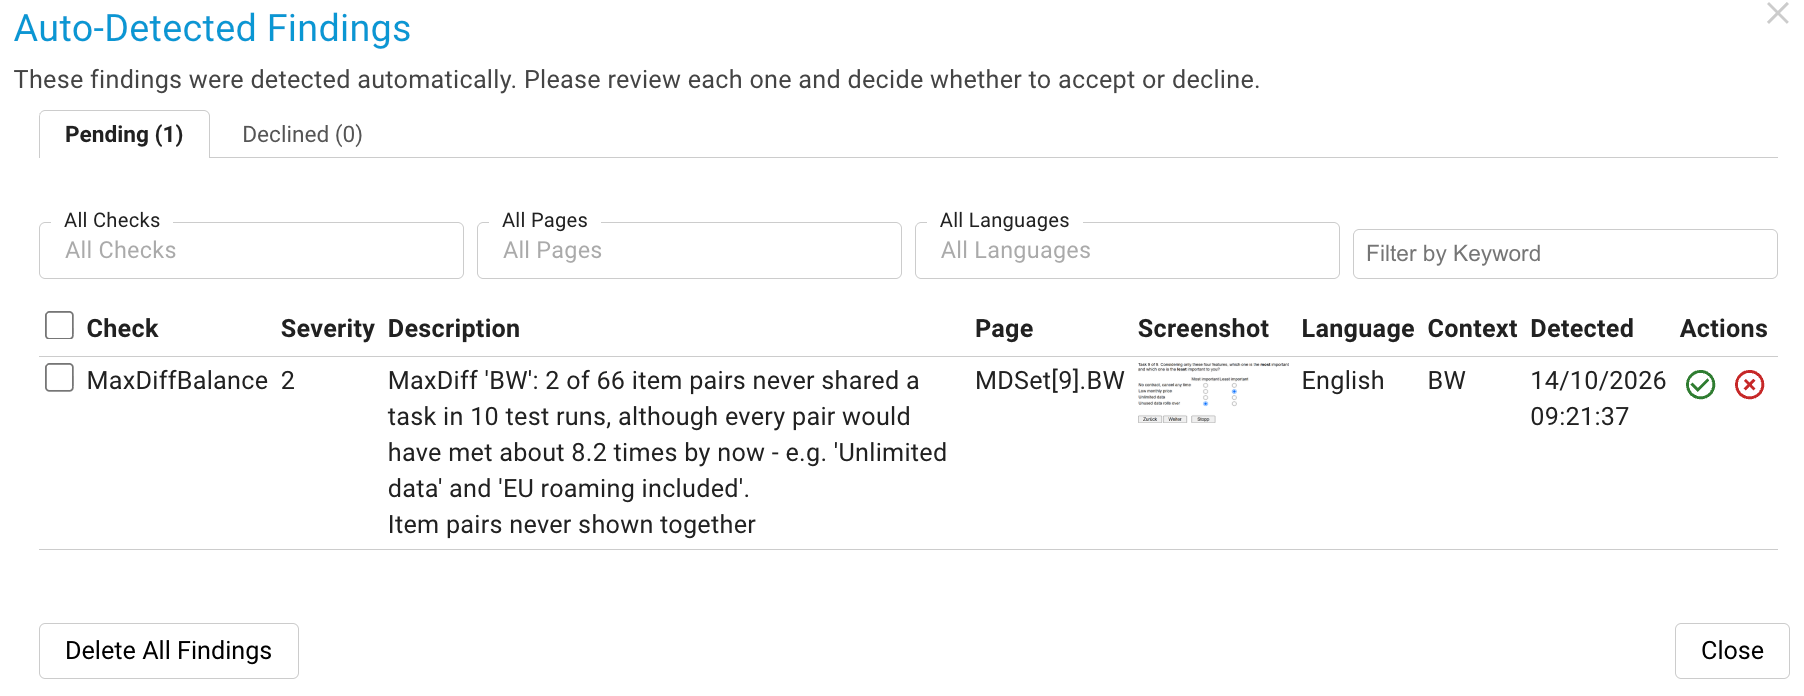
Die Prüfung lässt sich wie jede andere AutoDetect-Prüfung je Firma, Projekttyp oder Projekt ein- und ausschalten, siehe Auto Detect Issues.
Eine Korrektur mit einem Ergebnisfilter prüfen
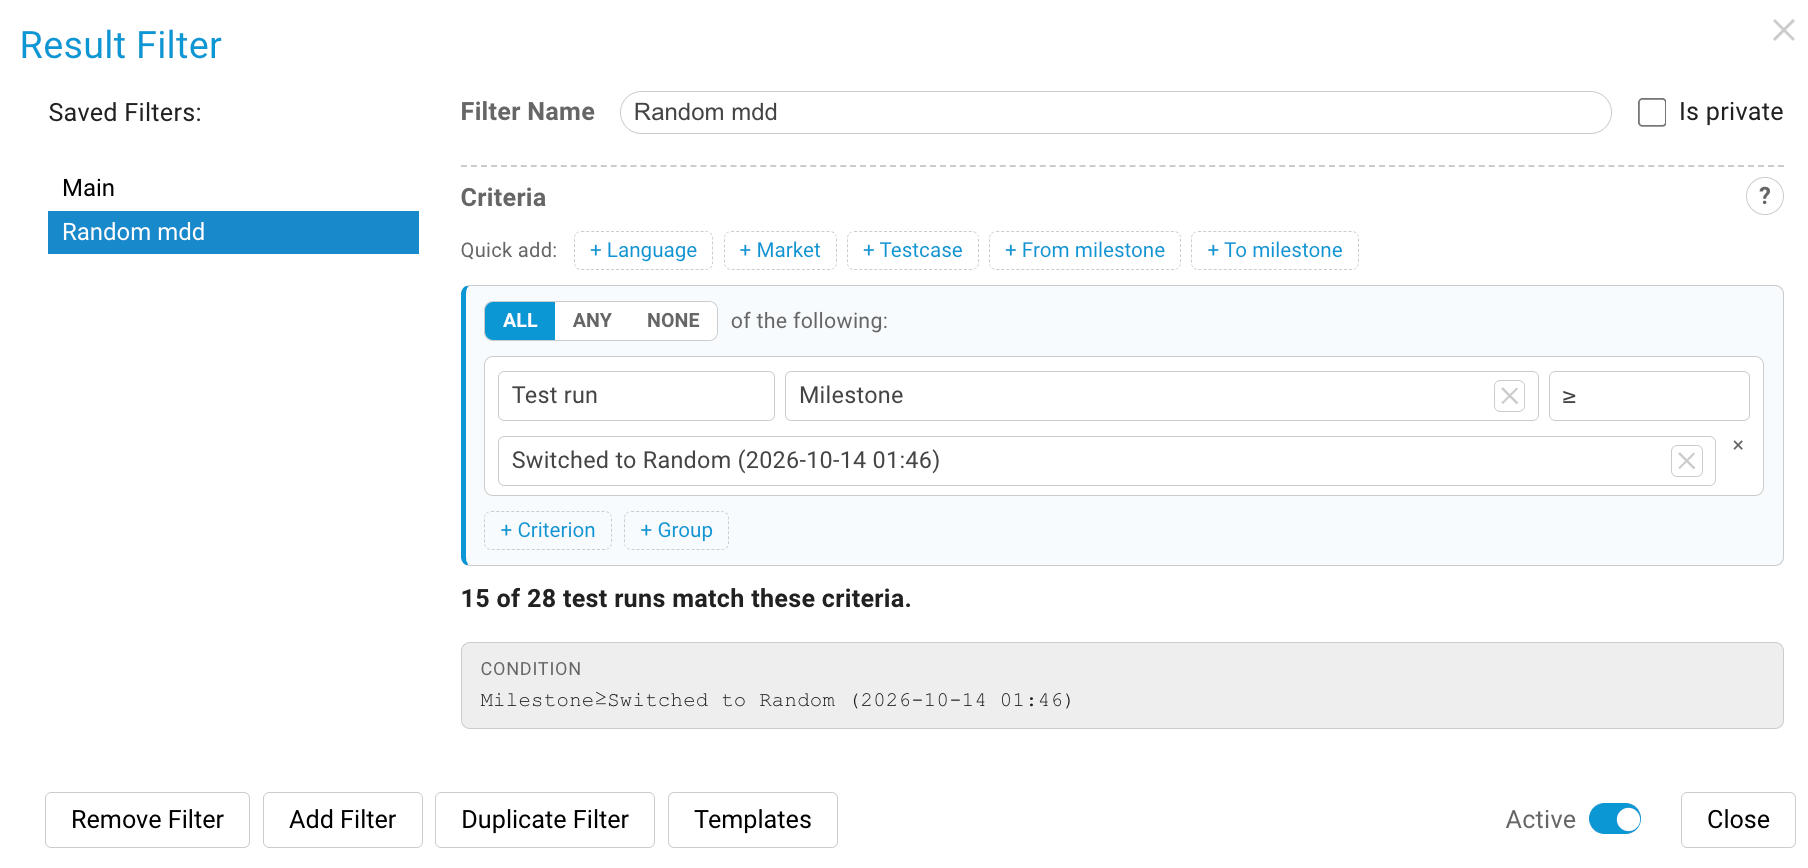
Der typische Zyklus: Ein Test-Schwung findet eine Abweichung, der Fragebogen-Autor korrigiert das Design, und du willst wissen, ob es jetzt gelöst ist. Setze einen Meilenstein zum Zeitpunkt der Korrektur und aktiviere ihn als Ergebnisfilter. Der Balance-Dialog wird dann nur für die gefilterten Testläufe berechnet und sagt das in einem Hinweis, während die Befunde die Historie behalten. Siehe Ergebnisfilter zu Filtern und Meilensteinen.
Eine Frage selbst als MaxDiff markieren
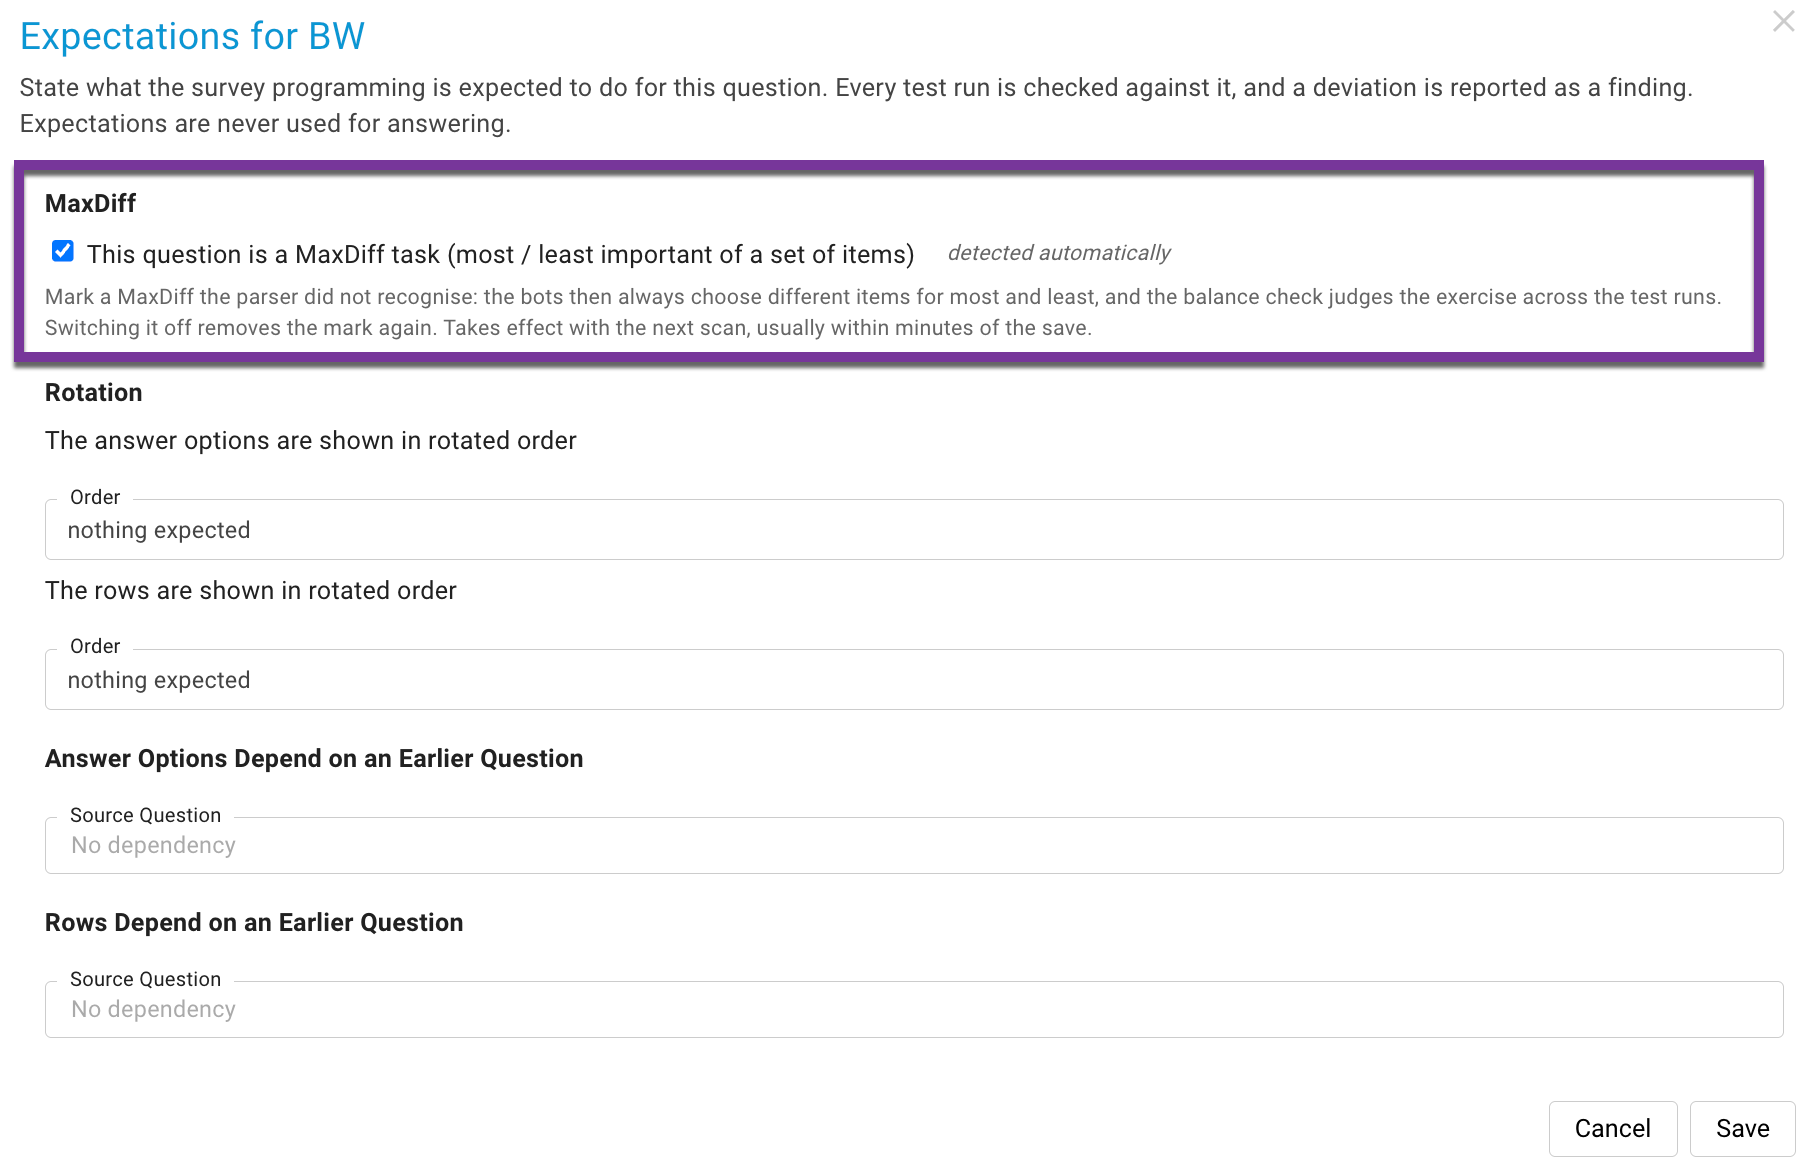
Erkennt SurveyTester eine MaxDiff-Aufgabe nicht - eine ungewöhnliche Vorlage oder eine Plattform ohne eigenen MaxDiff-Typ - öffne aus der Seitentabelle den Dialog Erwartungen der Frage und schalte Diese Frage ist eine MaxDiff-Aufgabe ein. Standardmäßig gilt der Schalter für alle Aufgabenseiten der Übung auf einmal. Ab dem nächsten Testlauf wählen die SurveyBots verschiedene Items als wichtigstes und unwichtigstes, und die Balance-Prüfung bezieht die Übung ein. Der Schalter ist nur für Fragen mit der Form einer MaxDiff-Aufgabe verfügbar: ein Grid mit zwei Spalten, je eine Einfachauswahl über dieselben Items. Bei anderen Fragen bleibt er sichtbar, aber deaktiviert, mit Angabe des Grunds.
Schritt für Schritt
- Lege das Projekt wie gewohnt mit dem Umfragelink an und starte einen ersten Testlauf, damit SurveyTester die Seiten erkennt.
- Öffne Seiten & Routing und prüfe, ob die Aufgabenseiten das MaxDiff-Balance-Symbol tragen. Falls nicht, markiere die Frage wie oben beschrieben.
- Starte einen Schwung SurveyBots. Zehn Läufe sind ein guter Anfang: genug für die Zeilen- und Paar-Prüfung, und bei Versionszuteilung nach Teilnehmernummer wird jede Version zweimal gesehen.
- Lade Seiten & Routing neu und öffne den Balance-Dialog. Lies das Urteil und die Beweislage; starte weitere Bots, wenn die Beweislage danach verlangt.
- Gib Abweichungen als Befunde oder Issues an den Fragebogen-Autor weiter. Setze nach der Korrektur einen Meilenstein, aktiviere ihn als Ergebnisfilter, starte den nächsten Schwung und prüfe, ob die Abweichung verschwunden ist.
Wie viele Testläufe reichen
| Eigenschaft | Nötige Läufe |
|---|---|
| Zeilenrotation | Etwa fünf: Eine rotierte Reihenfolge zeigt Paare schnell in beiden Reihenfolgen |
| Paarabdeckung | Genug Aufgaben, damit jedes Paar etwa dreimal zusammentreffen konnte; der Dialog zeigt den aktuellen Wert |
| Design-Versionen | Das Doppelte der Versionszahl bei Zuteilung der Reihe nach; bei zufälliger Zuteilung mehr, bis keine neue Aufgabenfolge mehr auftaucht |
| Wichtigstes nie gleich unwichtigstes | Mehr Läufe helfen nicht: Die SurveyBots geben diese Antwort nie. Prüfe die Regel mit einer absichtlich falschen Antwort in einem manuellen Lauf |
Die Beweislage-Zeile im Dialog wendet genau diese Regeln an und sagt dir, wann du aufhören kannst.
Hinweise
- Das Urteil ist relativ: Ein grüner Haken bedeutet, dass in den bisherigen Testläufen keine Abweichung zu sehen war, nicht, dass das Design statistisch optimal ist. Ein Design aus einem MaxDiff-Design-Werkzeug sollte alle vier Prüfungen bestehen.
- Die Paar-Prüfung kann nicht wissen, ob ein dünnes Design gewollt ist. Sie meldet ein Paar, das nie zusammen war, sobald jedes Paar mehrfach hätte zusammentreffen können; der Fragebogen-Autor entscheidet, ob das akzeptabel ist.
- Die Scores sind eine abgestufte Sicht neben dem harten Urteil: Häufigkeit als seltenstes durch häufigstes Item, Zeilen als Anteil der Paare in beiden Reihenfolgen, Paare als Abdeckung mal Gleichmäßigkeit.
- Die Balance-Prüfung funktioniert auf jeder Plattform gleich, auf der das MaxDiff erkannt oder markiert ist; die Design-Logik der Plattform selbst wird nicht gelesen.
Das Wichtigste
Ein MaxDiff lässt sich nicht durch einmaliges Durchklicken prüfen. SurveyTester durchläuft es wie Dutzende Teilnehmer, zählt, was jede Aufgabe gezeigt hat, und liefert ein Urteil samt Beweisen - bevor der erste echte Teilnehmer ein kaputtes Design sieht.