Eine Umfrageseite kann richtig aussehen und trotzdem falsch programmiert sein: Die Marken werden nicht randomisiert, „Keine davon" wandert durch die Liste, die Folgefrage zeigt Marken, die der Befragte nie gewählt hat. Solche Regeln sind auf einer einzelnen Seite unsichtbar. Fragen-Erwartungen lassen Sie sie einmal je Frage festhalten; jeder Testlauf wird dagegen geprüft, und eine Verletzung wird zum Befund.
Was eine Erwartung ist
Eine Erwartung ist eine Regel zu einer Frage und einer ihrer Listen - den Antwortoptionen oder den Gitterzeilen:
| Erwartung | Was sie besagt | Wie geprüft |
|---|---|---|
| Rotierte Reihenfolge | die Items erscheinen je Interview in anderer Reihenfolge; einzelne können verankert sein („Keine davon" immer zuletzt) | über Testläufe hinweg: dieselben Items müssen in verschiedenen Reihenfolgen erscheinen; ein verankertes Item muss seine Position halten |
| Feste Reihenfolge | die Reihenfolge darf sich nie ändern | über Testläufe hinweg: keine Rotation darf gefunden werden |
| Items aus einer früheren Frage | nur die an einer Quellfrage gewählten (oder nicht gewählten) Items werden gezeigt; bei Gittern die mit bestimmten Werten beantworteten Zeilen; oder die komplette Liste übernommen - wahlweise in gleicher oder umgekehrter Reihenfolge | je Testlauf: was die Quellfrage beantwortet hat gegen das, was die Zielfrage zeigte |
| Teilmenge pro Befragtem | jeder Befragte sieht N der Items, ausbalanciert oder zufällig gezogen | je Testlauf und über Läufe hinweg, siehe Fragen testen, die eine zufällige Teilmenge zeigen |
Items werden über ihren internen Wert zugeordnet, Testläufe in mehreren Sprachen zählen also zusammen.
Warum das ohne SurveyTester schwer ist
- Regeln leben in Notizen. „Randomisieren, 98 und 99 fest", „die bei Q5 gewählten Marken in gleicher Reihenfolge zeigen" - die Programmierung liest sie einmal; danach prüft sie niemand.
- Ein Interview beweist nichts. Rotation und Balance zeigen sich erst über viele Interviews.
- Piping-Fehler sind still. Eine Folgefrage mit den falschen Marken stürzt nicht ab; sie sammelt leise falsche Daten.
Wo Sie mit Erwartungen arbeiten
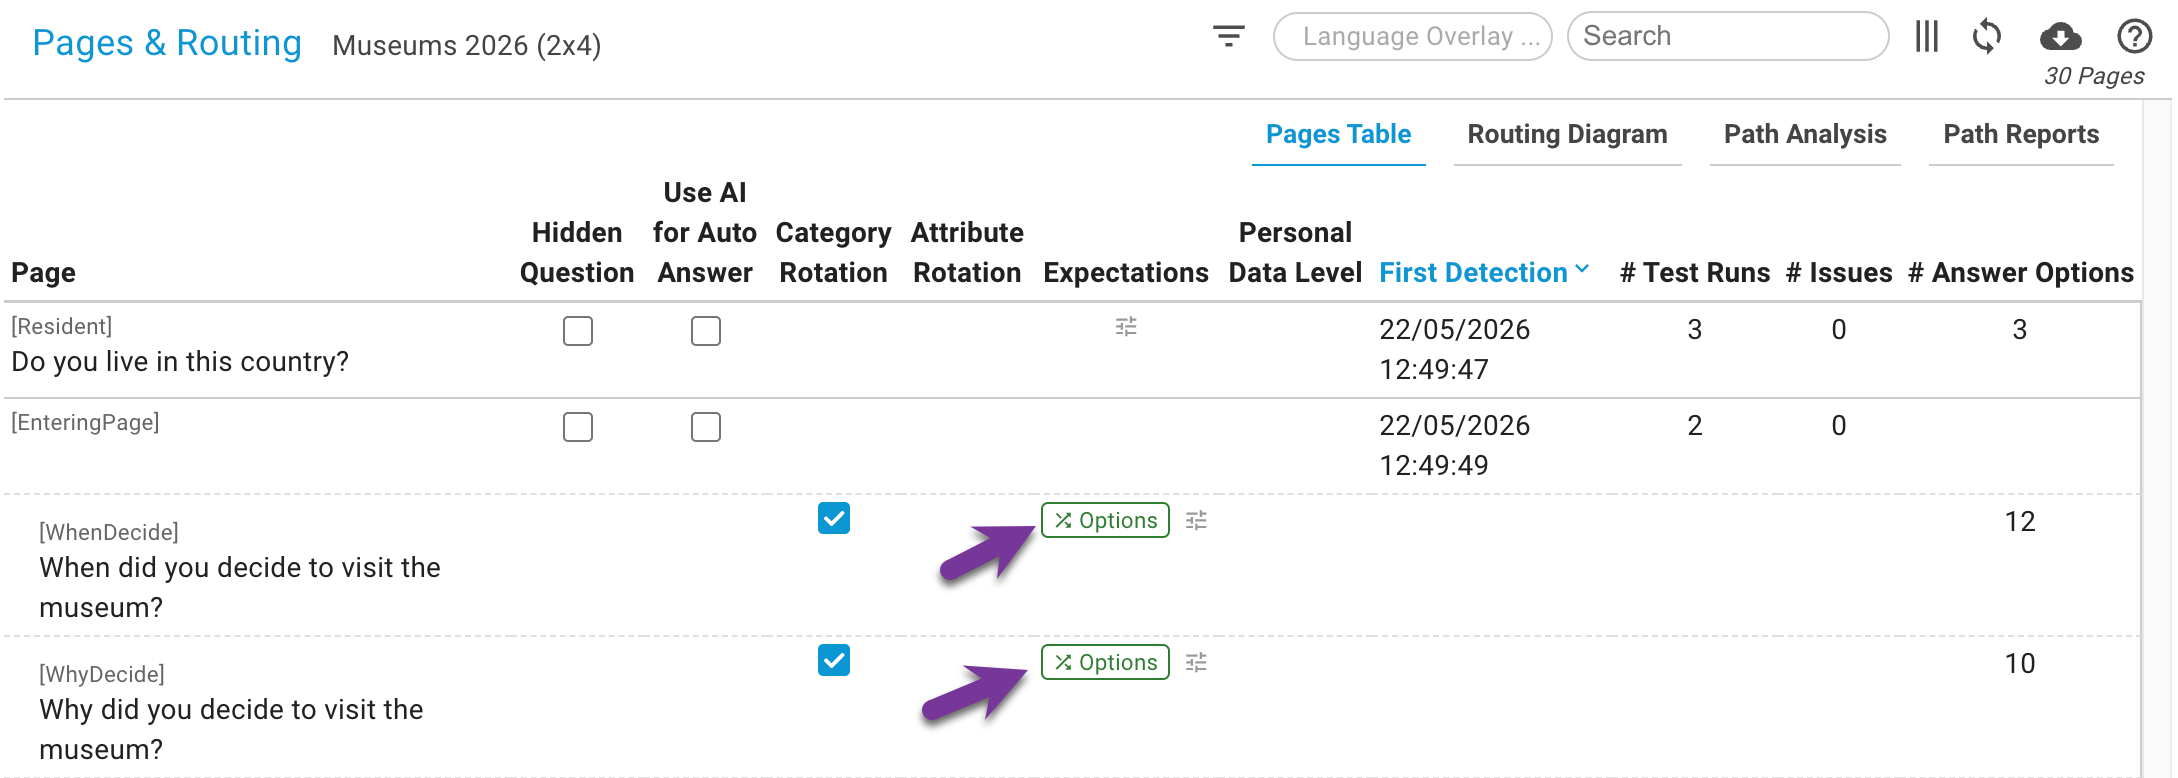
Öffnen Sie Fragen & Logik. Die Spalte Erwartungen zeigt je Frage, was festgehalten ist: ein Rotationssymbol für Optionen oder Zeilen (grün, wenn die Rotation in den Testläufen gefunden wurde, orange, solange sie fehlt), ein Schloss für eine feste Reihenfolge, ein Baumsymbol mit der Zahl der Abhängigkeiten und die Teilmengen-Schaltfläche.
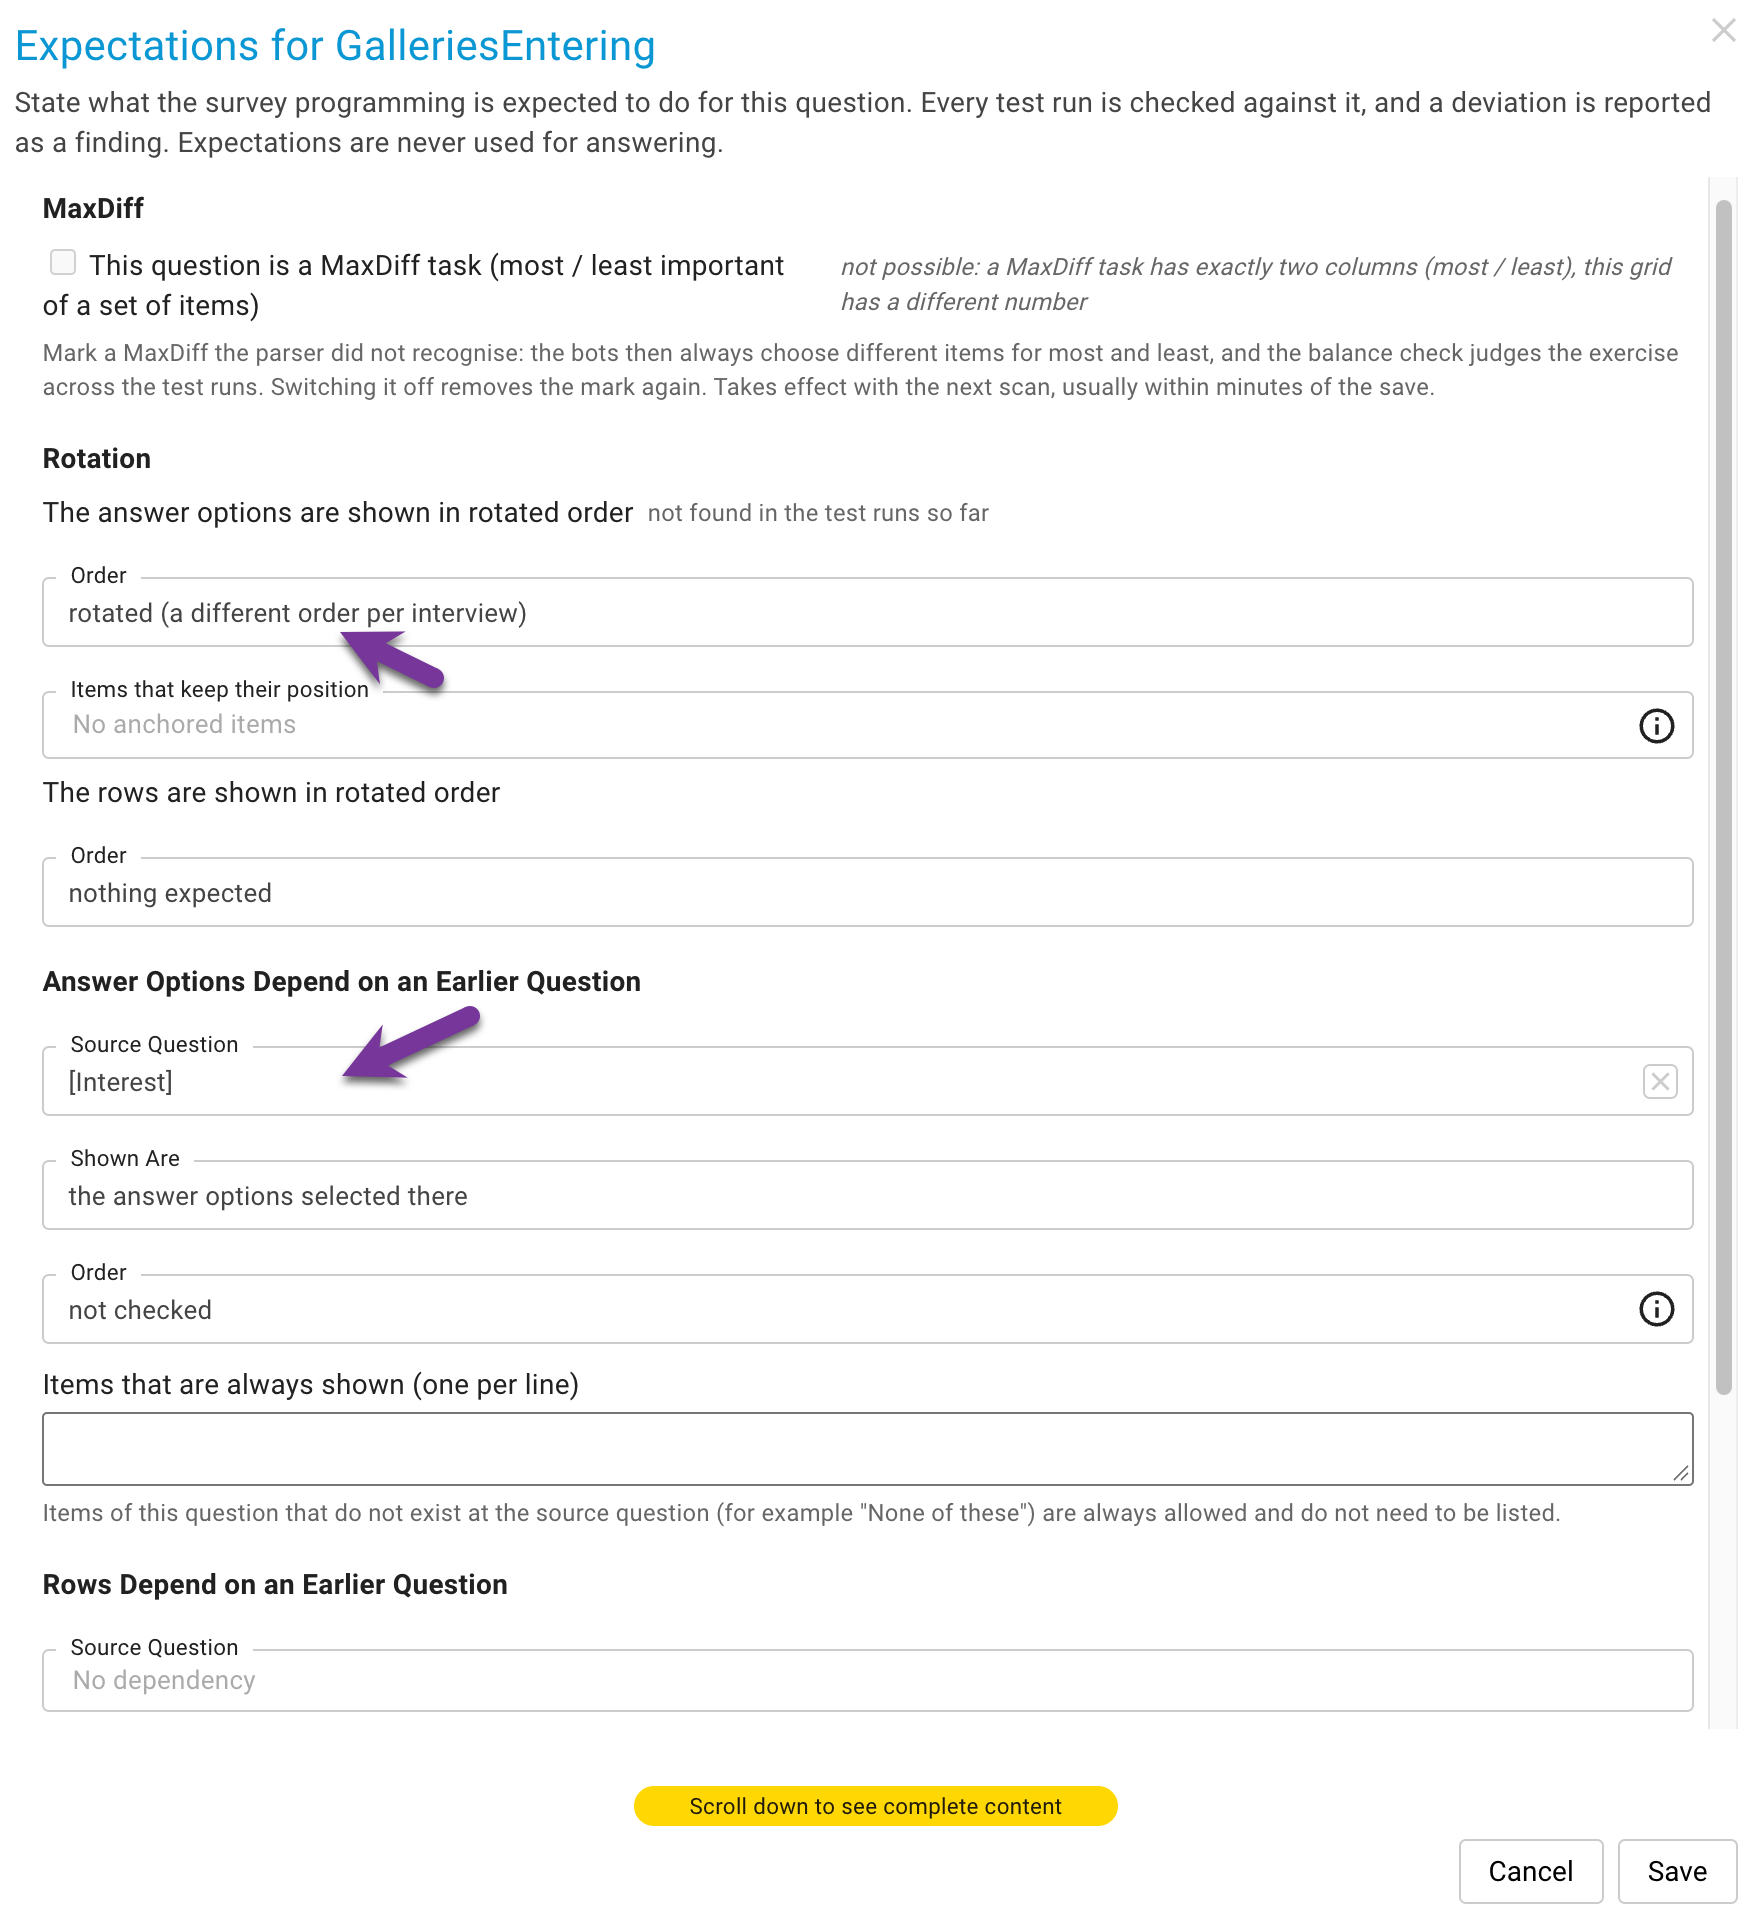
Das Bearbeiten-Symbol öffnet den Dialog Erwartungen der Frage mit einem Abschnitt je Regelart und je Liste:
- Rotation - nichts erwartet, rotiert (mit den Items, die ihre Position halten) oder fest. Das Urteil daneben sagt, ob die Testläufe eine Rotation gefunden haben.
- Antwortoptionen / Zeilen hängen von einer früheren Frage ab - die Quellfrage, was gezeigt wird (gewählt, nicht gewählt, mit bestimmten Werten beantwortete Zeilen, alle Items), die Reihenfolge (nicht geprüft, gleich, umgekehrt) und Items, die immer gezeigt werden („Keine davon").
- Teilmenge pro Befragtem - die Zahl der Items, die ein Befragter sieht, und die Ziehung.
- MaxDiff - eine Frage als MaxDiff-Aufgabe markieren, siehe MaxDiff-Fragen testen.
Drei Quellen einer Regel
- Von Hand im Dialog.
- Aus dem Fragebogendokument: Nach Abgleichen & prüfen werden die Randomisierungs-, Verankerungs-, Piping-, „same order as"- und Teilmengen-Anweisungen des Dokuments zu Regeln mit der Herkunft aus dem Fragebogen übernommen.
- Erwartungen vorschlagen (Schaltfläche über der Tabelle) liest die letzten Testläufe und schlägt Abhängigkeiten für jede Frage vor, deren Liste sichtbar aus einer früheren stammt; Herkunft aus den Testläufen vorgeschlagen.
Eine manuelle Regel überschreibt Dokument und Vorschlag; sie abzuschalten hält auch die untere Regel abgeschaltet, und Erwartung des Fragebogens verwenden entfernt die Überschreibung wieder.
Befunde
Verletzungen sind AutoDetect-Befunde unter den Prüfungen Erwartete Rotation, Von einer früheren Frage abhängige Einträge und Item-Anzeige: Der Befund nennt den ersten Lauf und die betroffenen Items, kann als Issue bestätigt oder abgelehnt werden und wird zurückgezogen, wenn sich die Regel ändert oder die Erwartung später erfüllt ist (etwa sobald die Rotation gefunden wurde). Der Dialog listet die Befunde jeder Regel. Die Prüfungen lassen sich wie jede andere ein- und ausschalten, siehe Auto Detect Issues.
Befunde erscheinen mit dem Projekt-Scan, der nach abgeschlossenen Testläufen läuft, meist innerhalb weniger Minuten.
Schritt für Schritt
- Starten Sie eine erste Serie von Testläufen, damit die Seiten erkannt werden.
- Klicken Sie Erwartungen vorschlagen und prüfen Sie die vorgeschlagenen Abhängigkeiten in den Dialogen.
- Ergänzen Sie, was der Vorschlag nicht wissen kann: Rotationen, feste Reihenfolgen, verankerte Items, Teilmengen - oder laden Sie das Fragebogendokument hoch und lassen Sie Abgleichen & prüfen das tun.
- Lassen Sie weitere Bots laufen; öffnen Sie die Befundliste und geben Sie Verletzungen an die Programmierung.
- Nach der Korrektur erneut laufen lassen: Befunde, die nicht mehr auftreten, werden zurückgezogen.
Das Wichtigste
Erwartungen machen aus Programmieranweisungen Prüfungen: Halten Sie einmal fest, was eine Frage tun muss, und jeder Testlauf sagt Ihnen, ob die Umfrage sich daran hält.